语音处理搬到自己电脑上,省掉的是按生成量付费这一项。VoiceStudio 把语音克隆、音色设计、视频配音、听写转录和有声书制作放进同一个桌面应用,模型下载到本机,参考录音和生成结果都不出这台机器。README 写它覆盖 646 种语言,应用代码按 AGPL-3.0 开源。
每月做多少才划算
ElevenLabs 官网定价页上,Creator 档首月 11 美元、之后每月 22 美元,给 121,000 credits。官方对比表把这个额度折算成约 121 分钟文字转语音,差不多两小时。偶尔合成几段旁白,这个量够用;每月要出几十小时有声书,或者成批给视频配音,两小时很快用完,得往上一档,Pro 是 99 美元、600,000 credits。配音和语音转文字也在同一档里扣 credits。
本地方案把月度支出换成一次性的模型下载和硬件开销,模型装好之后,生成多少都不再计数。省不省只看每月产量。稳定超过两小时,本机才开始省;产量低的话,装模型、换引擎搭进去的时间比省下的订阅费更贵。
装起来和跑起来
应用基于 Electron,Windows、macOS、Linux 都有安装包,macOS 和 Linux 还能直接跑一行脚本 curl -fsSL https://voicestudio.sh/install | sh,Homebrew 和 Docker 的方式列在 README 里。默认语音引擎是 k2-fsa/OmniVoice,转写用 Whisper 系模型,设置里可以换其他引擎。TTS、语音识别、说话人分离、翻译、LLM 这几类模型分开管理,用到哪一个才提示下载哪一个。
视频配音按句走:先把音频切成一句句,转写、翻译,再逐句合成,最后按原时间轴对齐。界面上 37 条分句逐条列着时间、说话人、原文、目标语言和音色,改一句可以只重新生成那一句。
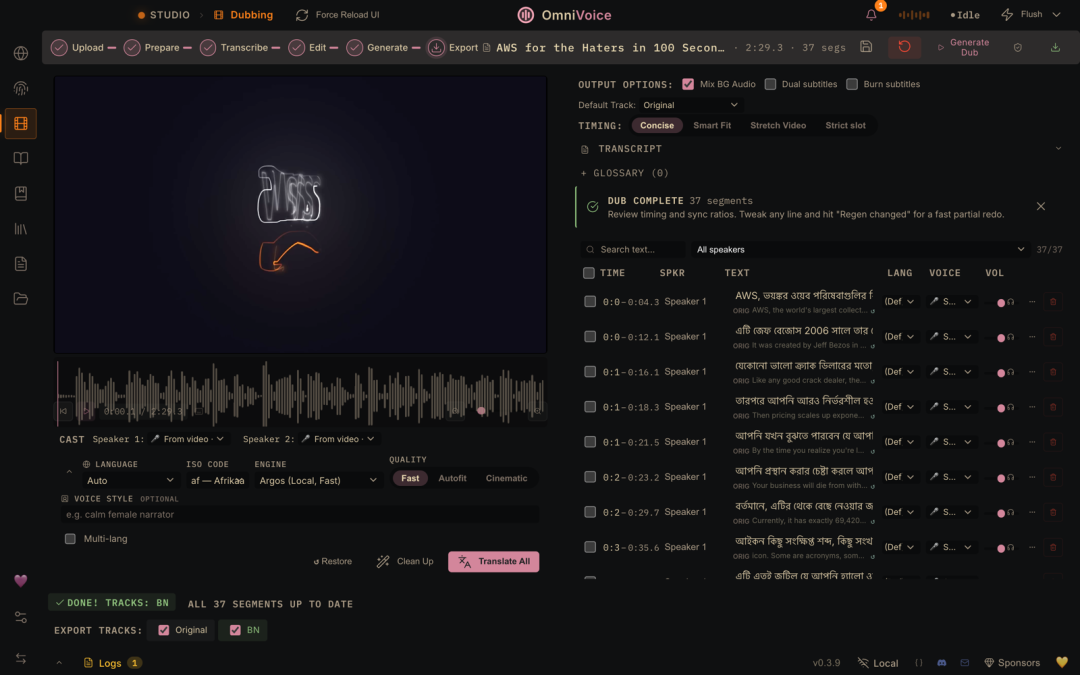
图 1 视频配音工作区把波形和 37 条分句并列,每条分句可单独指定语言、音色并重新生成。
模型不随安装包一起下发。设置页按用途分组列出已经装好的模型,纯 CPU 环境留出约 5 GB 空间能起步,装齐常用组合之后占用更高。应用还提供本地 API 和 MCP(让外部程序调用本机语音功能的接口),可以接进自己的脚本或 AI 客户端。
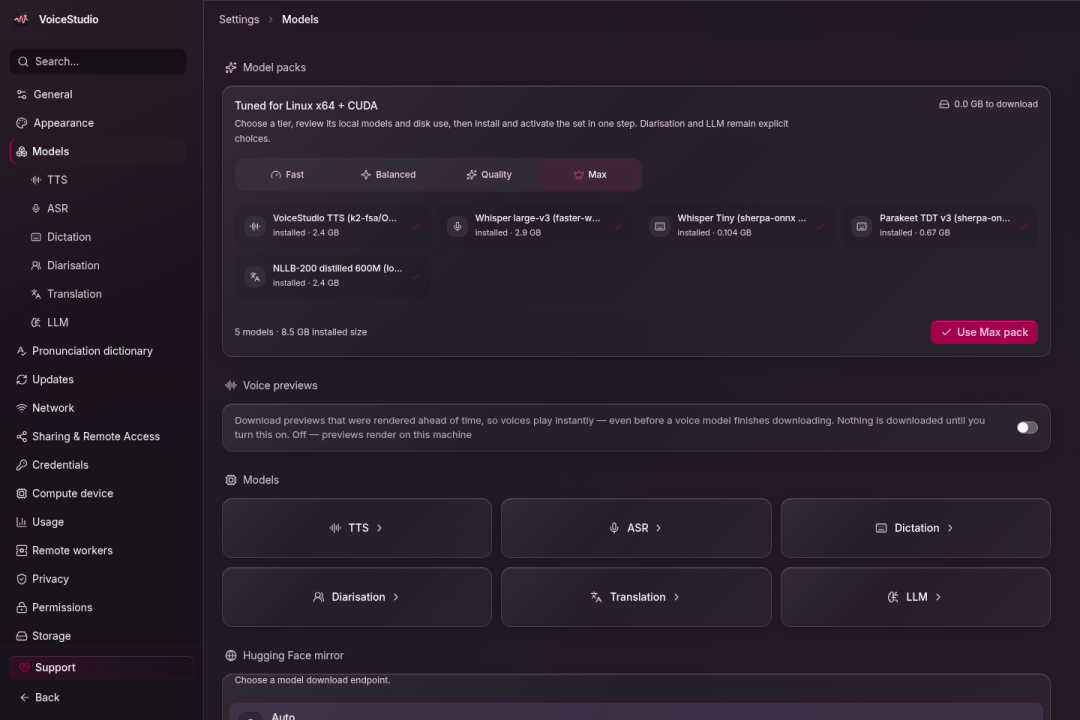
图 2 模型包按 Fast、Balanced、Quality、Max 分档,截图中已装 5 个本地模型、共占 8.5 GB。
体验最好的是走硬件加速,NVIDIA 显卡用 CUDA、Apple 芯片用 Metal。纯 CPU 也能跑,速度明显慢一截。Intel Mac 卡得更死:界面装得上,本地引擎跑不起来,只能去连另一台机器上的后端。磁盘占多少取决于装了几个模型,跟安装包大小关系不大。
121 分钟/月的官方额度对上 8.5 GB 的模型占用,换不换就有数了。每月稳定做十小时以上配音或转录、机器又带独立显卡或 Apple 芯片,换到本机之后每多生成一小时几乎不再增加成本。每月只合成几分钟语音,云端免费档那 10,000 credits 足够,不必先花时间装模型。
许可要单独核对
README 写明 AGPL-3.0 覆盖应用本身,按其条款允许商用。模型权重、音色和生成结果各有各的许可,Model Manager 会逐个显示。语音克隆多一道前提,要先取得声音本人同意,README 里单列了这一条。
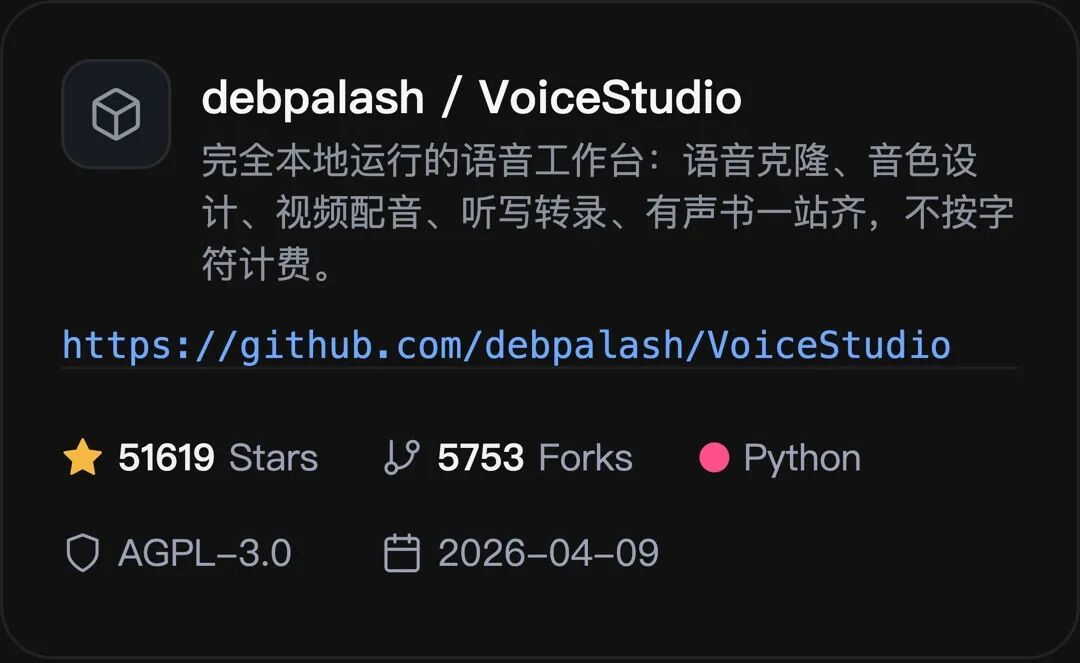
图 3 仓库页截图显示 AGPL-3.0 协议、Python 和 51,619 星。
项目另有付费的闭源商业授权和云端托管服务:应用免费,不代表所有用法都免费。
要交付客户,先核对所用模型权重和音色的条款允不允许商用,再算能省多少订阅费。能不能用由条款决定,划不划算才是订阅费的事。Model Manager 逐条列出这些条款,但生成音频时不会替人判断。
评论
还没有人留言。